Note technique
Des LLM sur CPU uniquement : 2 372 mesures sur un bi-Xeon de 2019
Peut-on servir des LLM correctement sans GPU ? Nous avons mesuré pendant plusieurs jours un bi-Xeon de 2019 acheté d'occasion : débits, NUMA, quantification, concurrence. Toutes les données brutes sont publiées.
Avant d’ajouter un GPU, nous voulions savoir ce que pouvait déjà servir un bi-Xeon d’occasion. Une fois le modèle chargé en RAM, la génération sur CPU dépend souvent davantage du débit et de la latence des accès mémoire que du nombre de cœurs. Un serveur de 2019 à 500 € a assez de RAM pour charger un modèle de 60 Go ; ce qui décide du débit, c’est la vitesse à laquelle les cœurs relisent ces poids à chaque token. Une fois ce cadre posé, tout le reste découle : le choix du runtime, le nombre de threads, le placement NUMA, la quantification et les limites du service d’API. Nous avons mené une campagne complète de mesures pour remplacer les intuitions par des chiffres.
Le vrai problème : capacité contre bande passante
Chaque token généré impose de relire l’essentiel des poids actifs du modèle. Avec des MoE à experts actifs réduits (3 milliards de paramètres actifs pour 30 à 80 milliards au total), la quantité à relire par token reste modérée : c’est exactement pour cela que cette classe de modèles change la donne sur CPU. Un modèle dense de 27 milliards, lui, sollicite bien davantage de poids à chaque token. Sur notre machine, son débit reste nettement inférieur à celui des MoE retenus.
La capacité mémoire reste le garde-fou : elle fixe la taille maximale du modèle résident et la place laissée au cache KV. Mais entre deux modèles qui tiennent en RAM, c’est la bande passante qui départage. Toute l’étude peut se lire comme une variation autour de ce principe : réduire les octets à relire (quantification), rapprocher les données des cœurs (NUMA), et ne pas saturer le bus par de la concurrence mal placée.
La machine et le protocole
Le plateau de test est un serveur de 2019 : deux Xeon Gold 6230 (Cascade Lake), soit 40 cœurs et 80 threads, environ 256 Go de RAM installés dont 195 Gio alloués au conteneur LXC dédié au test, sous Proxmox (noyau 7.0.14-20-pve). Détail important pour la bande passante : chaque CPU peut adresser 6 canaux mémoire, mais seulement 4 sont peuplés (8 barrettes de 32 Go). La machine a été achetée d’occasion pour environ 500 € (prix rapporté, pas un coût total de possession). Sa consommation observée au plateau tourne autour de 400 W ; c’est une observation ponctuelle, pas une mesure continue, et nous ne nous risquons pas à en dériver un coût énergétique précis. Remplir les deux canaux manquants augmenterait le parallélisme mémoire théorique d’environ 50 % ; ce gain n’est pas mesuré ici et nous ne l’extrapolons pas.
Le protocole repose sur llama-bench : deux tests distincts : traitement d’un prompt de 512 tokens, sans génération, et génération de 128 tokens sans contexte préalable. Chaque test est répété trois fois, moyenne et écart-type consignés. Cache KV en f16 par défaut, batch 2048, micro-batch 512, flash attention en mode automatique et repack selon les options du runtime. Le CSV conserve les valeurs demandées et celles réellement rapportées. Deux runtimes ont été chronométrés : ik_llama.cpp (noté ik) et llama.cpp upstream (build CPU). FastLLM a été essayé mais a échoué à l’import : il est compté comme évalué, jamais comme mesuré. Chaque exécution reçoit un identifiant de configuration (config_id) qui traverse tout le jeu de données : commande exacte, horodatage, noyau, dépôt et révision Hugging Face, RSS de pointe. La révision du build ik est marquée unknown dans ces enregistrements : nous n’inventons pas de commit pour combler cette lacune.
Définition des compteurs, car ils se mélangent facilement : 2 372 lignes agrégées (une ligne = une phase de test pour une configuration), 1 233 configurations tentées dont 1 219 réussies, 12 en échec et 2 non prises en charge, pour un total de 7 074 répétitions chronométrées. Quatorze variantes modèle-quantification couvrent la gamme, de gpt-oss-20b à gpt-oss-120b et de Qwen3-30B à Qwen3-Next-80B. Sauf mention contraire, les chiffres qui suivent portent sur le noyau courant 7.0.14-20-pve. Dernière précision de périmètre : le balayage n’est pas une matrice cartésienne complète. Les phases testées diffèrent selon le modèle et le runtime (la phase contexte et la phase batch n’existent pour Qwen3.6 que sur le runtime upstream, pas sur ik) ; chaque graphique indique donc son modèle, son runtime et son profil exact.
Le classement général
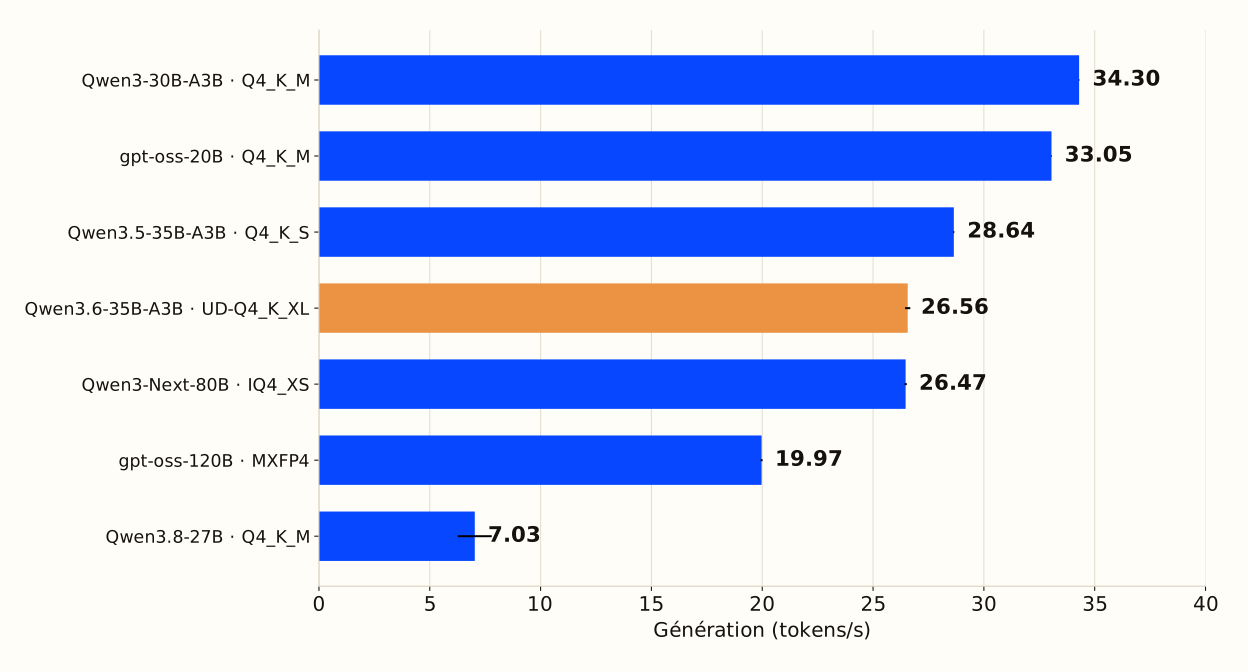
les MoE à 3 milliards de paramètres actifs dominent, et l’ordre d’arrivée dépend bien plus de l’architecture que du nombre total de paramètres. Qwen3-30B-A3B en Q4_K_M mène à 34,30 tok/s (config 70675e19e778a871ca), devant gpt-oss-20b en Q4_K_M à 33,05 et en MXFP4 à 30,97. Qwen3-Next-80B, souvent présenté comme la référence, atteint 26,47 tok/s : c’est le modèle le plus rapide de sa catégorie de taille, pas le plus rapide de l’étude. Nous corrigeons ici notre propre PDF de synthèse, dont la couverture attribuait au 80B le titre de modèle le plus rapide ; c’était faux. Le modèle dense Qwen3.8-27B confirme la règle à l’envers : 7,03 tok/s malgré 40 threads, environ 3,5 sur le runtime upstream. Un seul chiffre résume l’écart : cinq fois moins de débit qu’un MoE plus gros en paramètres totaux.
Le choix du runtime vaut un facteur 2
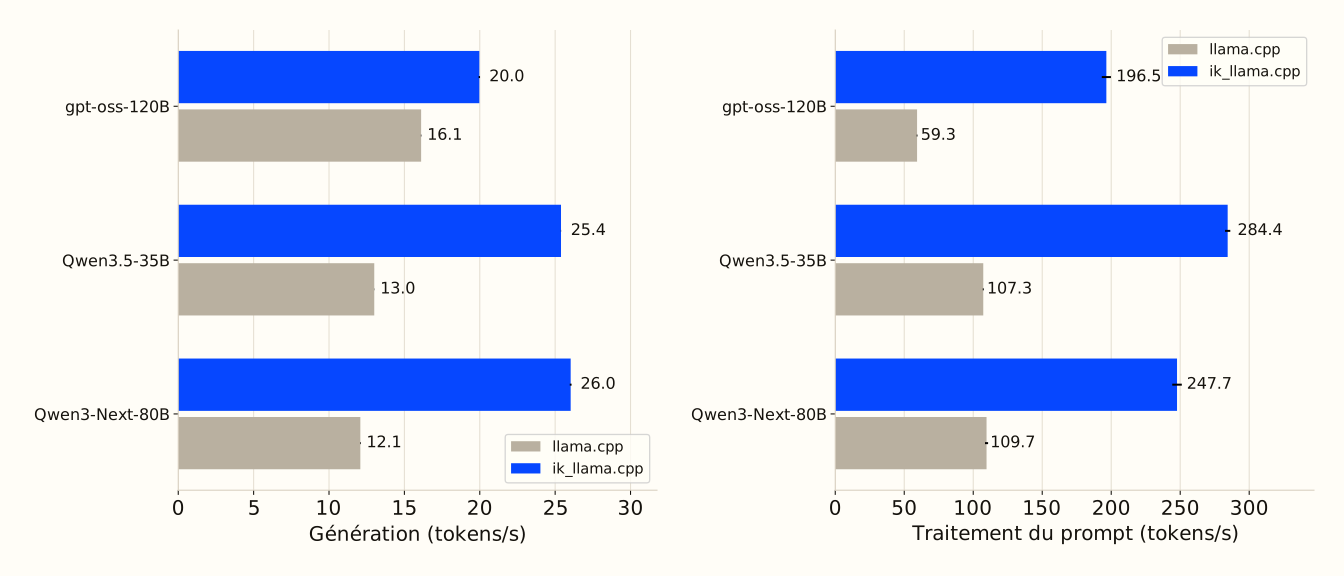
sur profil identique, le runtime pèse plus que le matériel. Les comparaisons honnêtes exigent des configurations appariées ; nous les avons produites (phase final-matched : nœud 1, 16 threads, KV f16). Sur Qwen3-Next-80B IQ4_XS, ik délivre 26,03 tok/s en decode contre 12,08 pour upstream, soit 2,15 fois plus (configs 9d81c9b3c2baf30747 et be09e70fc78ec3a8db) ; en prefill, 247,70 contre 109,65, soit 2,26 fois plus. Sur Qwen3.5-35B Q4_K_S, le rapport est de 1,95 en decode ; sur gpt-oss-120b MXFP4, 1,24 en decode mais 3,31 en prefill. Attention au piège classique : comparer le meilleur run ik d’un modèle au meilleur run upstream d’un autre revient à comparer des choses non appariées. Le classement ci-dessus est un classement des meilleures configurations, pas un duel de runtimes.
Les threads : moins, c’est plus
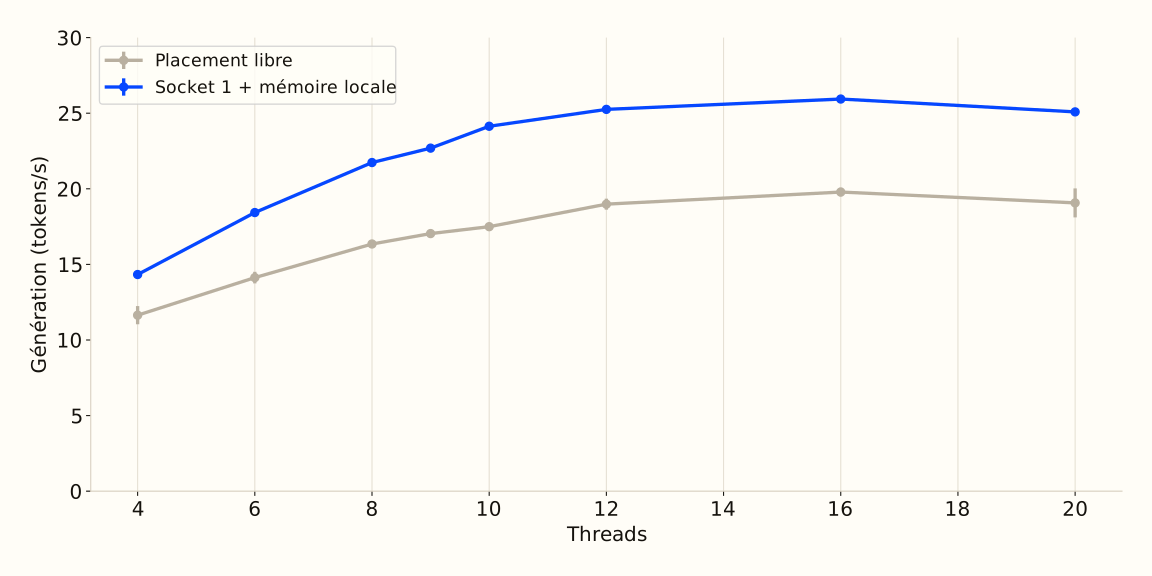
16 à 20 threads suffisent, et 40 threads n’aident pas les MoE. Sur Qwen3-Next-80B avec ik, la courbe de threads présentée atteint 25,94 tok/s à 16 threads sur le nœud 1, contre 19,78 en placement libre, puis retombe à 25,09 à 20 threads. Le meilleur résultat de 26,47 tok/s vient d’une autre phase, le contrôle NUMA, et ne remplace pas un point de cette courbe. La charge ne bénéficie donc pas systématiquement de threads supplémentaires ; la contention mémoire et les coûts de synchronisation sont des explications possibles, pas des compteurs matériels mesurés ici. Les meilleures mesures de toute l’étude se situent toutes entre 16 et 20 threads. Le meilleur profil synthétique du modèle dense utilise 40 threads pour 7,03 tok/s. Cela ne démontre pas qu’il exige toujours 40 threads, ni qu’il soit inutile pour toutes les charges. Le réflexe « ajouter des cœurs » ne s’applique pas à cette charge.
NUMA : le placement CPU et mémoire, pas seulement le CPU
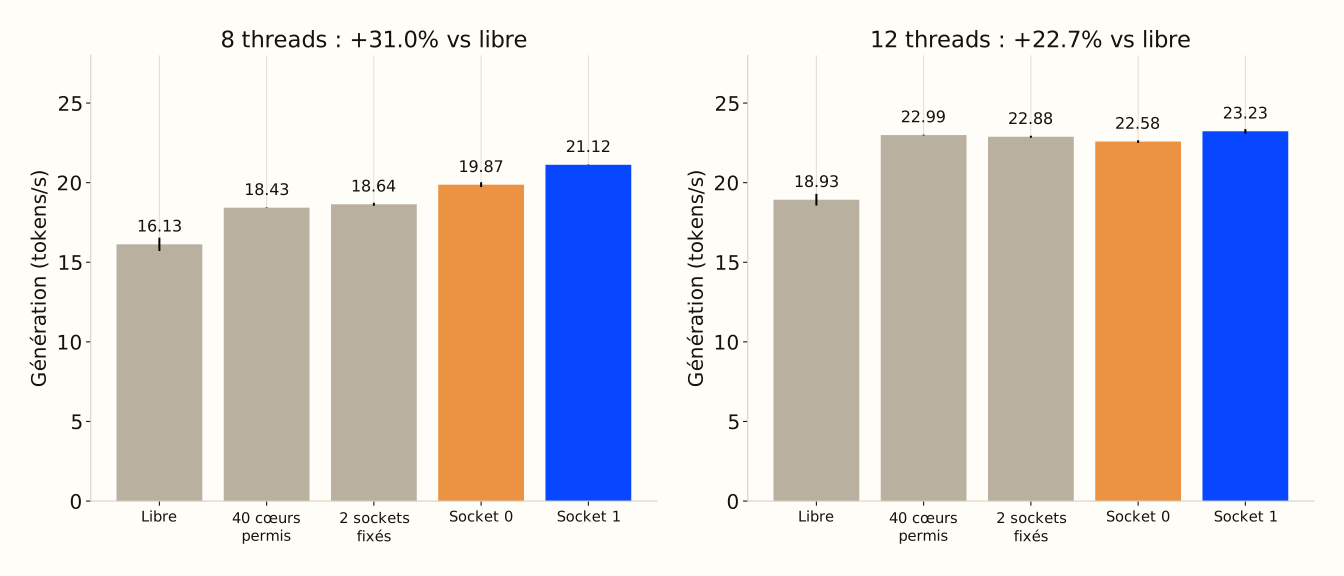
épingler processus et mémoire sur un seul nœud NUMA vaut jusqu’à 31 % de débit supplémentaire, sans changer une ligne de code. Sur Qwen3.6-35B Q4_K_XL à 8 threads, le placement automatique donne 16,13 tok/s ; les cœurs et la mémoire épinglés au nœud 1 montent à 21,12 tok/s, soit +31 % (configs e5bc2c60ff06cb4918 et 118bdf5e97e918b6c3). À 12 threads, même histoire : 18,93 en automatique contre 23,23 sur le nœud 1, +22,7 % (ed060c8dcbfd608922). Précision importante : c’est l’effet combiné du placement des cœurs et de la politique mémoire (membind), pas un réglage CPU seul. Fait notable, un placement à cheval sur les deux nœuds (cross) fait presque aussi bien que le nœud unique à 12 threads (22,88 tok/s) ; ce test favorise une politique explicite de placement, sans établir que les accès distants sont l’unique cause des écarts. Le motif de commande est reproductible :
numactl --physcpubind=<coeurs-du-noeud> --membind=<noeud> \
  llama-bench -m <modele.gguf> -t 16 -p 512 -n 128 -r 3 -ngl 0
Quantification : on mesure la vitesse, pas la qualité
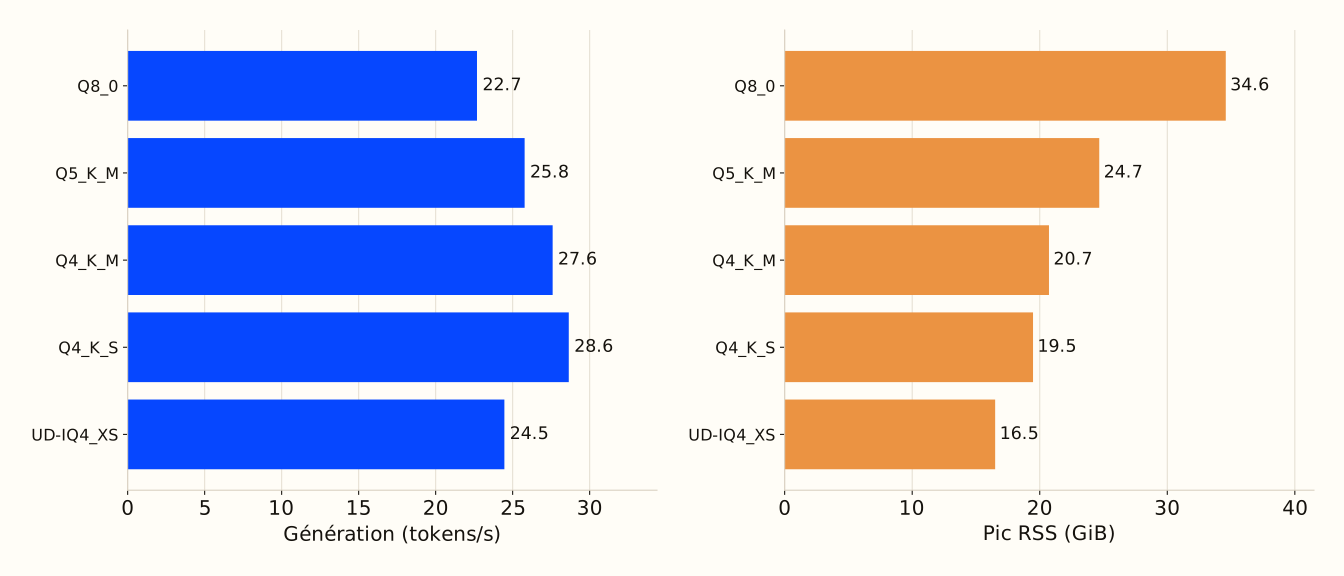
sur cette machine, descendre de Q5 à Q4 gagne peu en débit mais beaucoup en mémoire. Qwen3.6-35B en UD-Q4_K_XL tourne à 26,56 tok/s avec un RSS de 21 Gio ; en UD-Q5_K_XL, 25,39 tok/s pour 25 Gio. En Q8_0 (Qwen3.5), 22,68 tok/s et 35 Gio. Le vrai arbitrage se joue entre capacité (combien de répliques tiennent sur la machine) et volume d’octets à relire par token. Ce CSV de performances ne mesure pas la perte de qualité entre quantifications. Les diagnostics API de la campagne ne remplacent ni une mesure de perplexité ni une évaluation métier comparative. La présomption « Q4 dégrade moins que avant » reste une présomption ; à valider sur vos cas d’usage, prompt par prompt, avant d’industrialiser.
Contexte long et cache
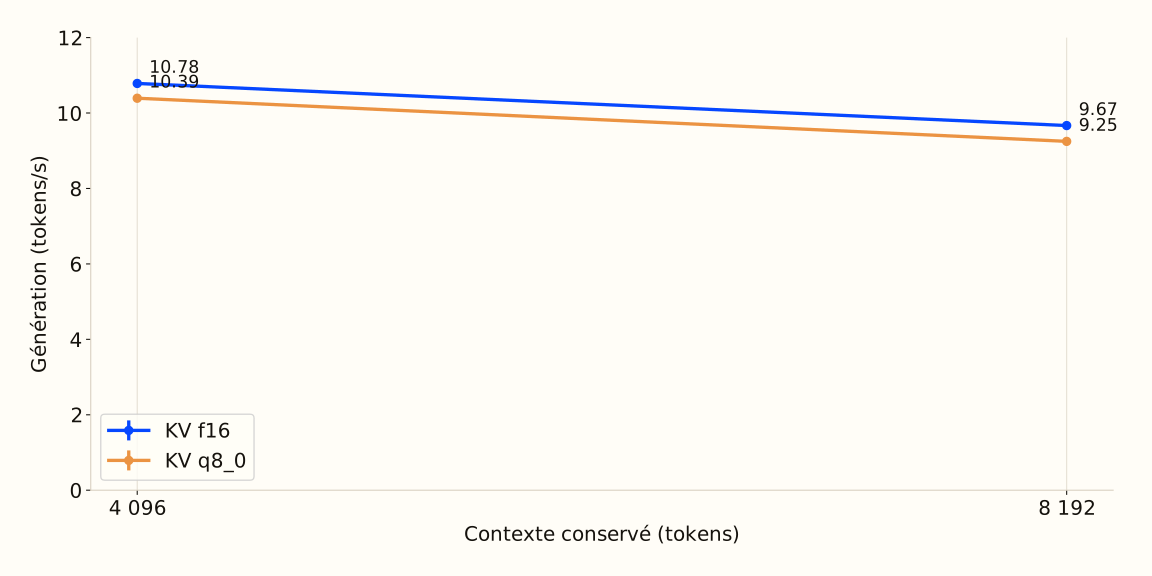
le contexte se paie, et le cache KV devient une variable de capacité à part entière. Les mesures contrôlées montrent un débit qui glisse de 10,78 tok/s à 4 096 tokens de contexte pré-rempli (KV f16) à 9,67 tok/s à 8 192 tokens ; en KV q8_0, 10,39 puis 9,25 tok/s. Sur ce profil upstream, le passage de 4k à 8k coûte donc environ 10 % de débit, et quantifier le cache (q8_0 plutôt que f16) divise environ par deux l’empreinte du KV au prix d’environ 4 % de débit ici (10,39 contre 10,78 tok/s à 4k). C’est un échange mémoire contre vitesse à arbitrer selon la longueur de vos contextes. Note d’honnêteté : le chargement mlock était demandé dans la commande, mais rien ne garantit qu’il ait été honoré à l’intérieur du conteneur LXC ; le RSS mesure la résidence mémoire du processus, pas la réussite de mlock. Côté serving, le cache de prompt (réutilisation du préfixe entre requêtes) est le levier de latence dominant pour les charges en conversation répétée ; nous ne publions pas de TTFT chiffré pour cette campagne, nos mesures de latence initiale sur les runs de concurrence ayant été invalidées par un défaut d’horloge côté client. Nous préférons un trou documenté qu’un nombre inventé.
Batch et prefill : ce que le CPU absorbe bien
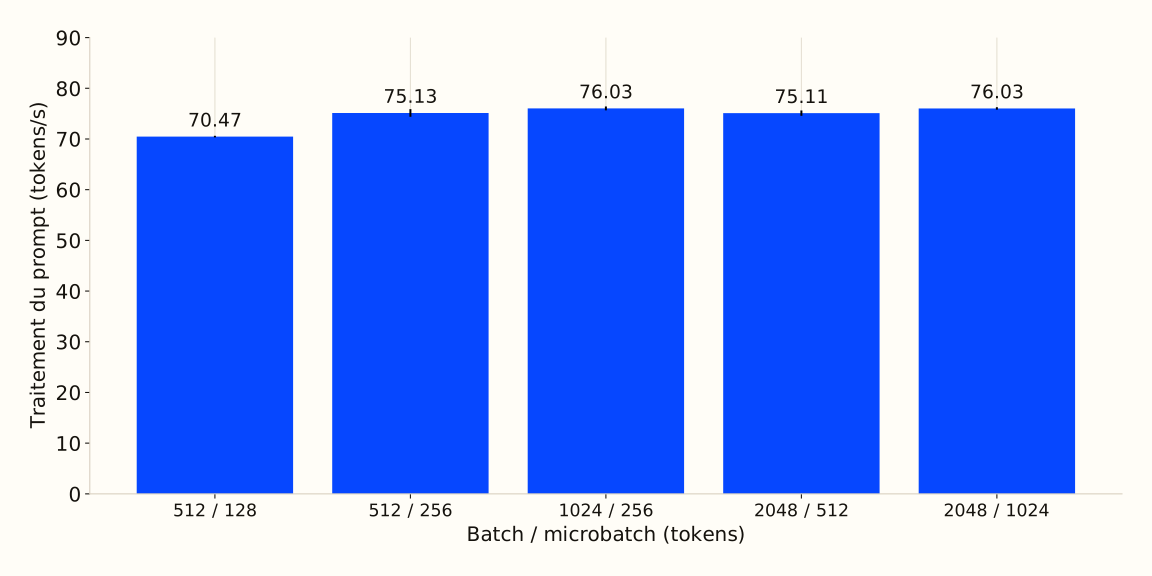
le prefill est la phase que le CPU encaisse le mieux, et elle profite des batchs larges. Sur ce profil upstream, le prefill de 512 tokens passe de 70,47 tok/s en batch 512 / micro-batch 128 à 76,03 tok/s en batch 2048 / micro-batch 1024, avec les paliers intermédiaires (75,13 en 512/256, 76,03 en 1024/256, 75,11 en 2048/512) presque tous au même niveau ; le gain se fait surtout en sautant le premier échelon, puis plateau. Le decode mesuré dans la même phase reste entre 11,34 et 11,50 tok/s : ne mélangez pas ces valeurs avec les 26 tok/s du runtime ik sur d’autres profils, ce sont des runtimes et des configurations différents. Pour une charge riche en prompts longs et pauvre en génération (résumé, extraction, classification), un CPU bien réglé est donc plus pertinent que le seul chiffre de decode ne le suggère. Inversement, une charge conversationnelle à génération longue restera limitée par le decode.
Servir une API : la concurrence est le vrai mur
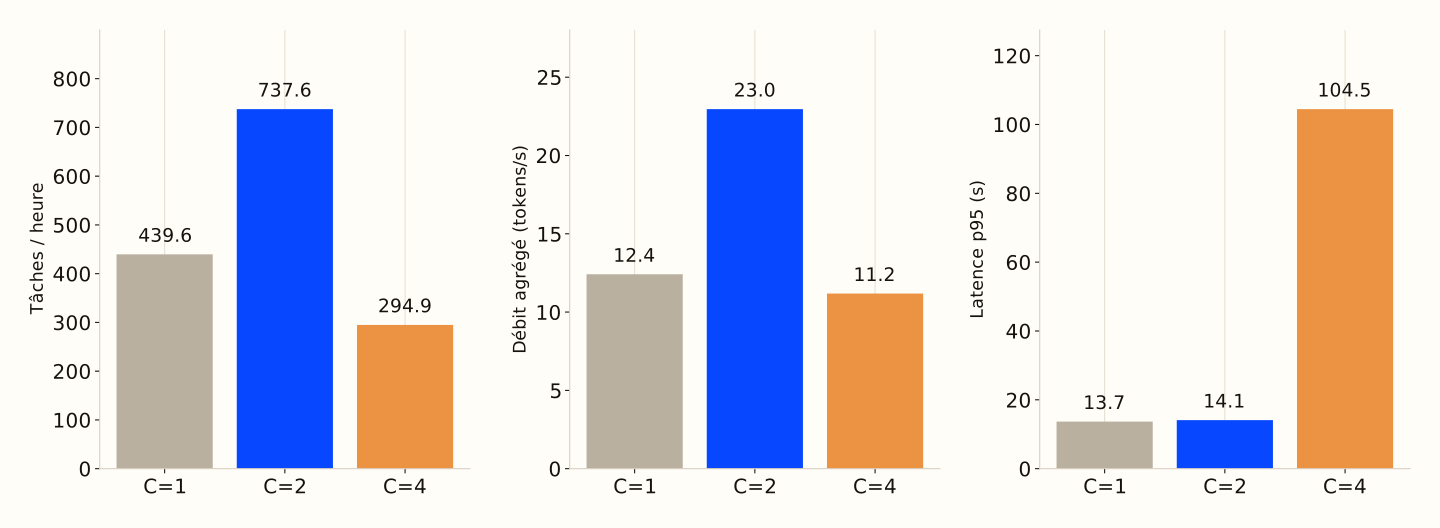
deux répliques bien placées absorbent une concurrence modérée, mais la machine plie au-delà. Deux instances de Qwen3-Next-80B IQ4_XS, chacune épinglée à son nœud NUMA (16 threads), traitent 6 tâches au total avec un seul client actif (C=1), soit un débit extrapolé de 440 tâches/heure. Avec deux clients actifs (C=2), 12 tâches au total donnent 738 tâches/heure (+68 %). Avec quatre clients actifs (C=4), 24 tâches au total donnent un résultat dégradé : 295 tâches/heure, un débit agrégé de 11,2 tok/s contre 23,0 à C2, et une latence p95 qui explose de 14,1 à 104,5 secondes. Les deux répliques restent résidentes en mémoire tout du long ; le collapse à C4 est cohérent avec une saturation de la bande passante mémoire locale, mais nous n’avons pas mesuré ce mécanisme : c’est une hypothèse étayée, pas un diagnostic. Limite méthodologique assumée : il s’agit d’une montée en concurrence sur deux répliques, pas d’un A/B isolé une réplique contre deux ; les sorties n’ont pas été comparées mot à mot et l’échantillon est petit. Ces chiffres bornent un usage, ils ne fondent pas une plateforme de serving public.
Ce que nous recommandons pour un déploiement CPU uniquement
Sur cette classe de matériel (bi-socket 2019, RAM large, pas de GPU), le CPU uniquement est viable pour des charges internes : assistant, traitement par lots, extraction, support d’agent. Le profil que nous retenons : un MoE A3B (la famille Qwen3.6-35B est notre défaut pratique, choisi par l’opérateur pour sa fraîcheur et son écosystème, pas comme vainqueur objectif d’un test de qualité que nous n’avons pas mené), quantification Q4, runtime ik, 16 à 20 threads épinglés sur un nœud NUMA avec membind, KV f16 (q8_0 si le contexte dépasse quelques milliers de tokens), batch 2048 et micro-batch 512. Les meilleurs tests synthétiques sans contexte atteignent 20 à 34 tok/s selon le MoE. Ce n’est pas une promesse de débit par conversation : le contexte, le format de sortie et la concurrence changent le résultat. Le pic RSS d’un bench court n’inclut pas nécessairement le budget d’un serveur avec de longs contextes et un cache de prompt. Les limites sont tout aussi claires : pas de dense au-delà du sacrifice, pas de haute concurrence non bornée (bornez les requêtes actives et la file d’attente : le test se dégrade à quatre clients simultanés sur deux répliques), un prefill correct mais sans GPU, et aucune de ces mesures ne s’extrapole à un autre socket, à DDR5 ou à un runtime plus récent.
Reproducibilité : les données sont publiées
Tous les chiffres de cet article viennent du CSV téléchargeable, avec le dictionnaire de données et chaque identifiant de configuration cité (par exemple 70675e19e778a871ca pour le 34,30 tok/s de Qwen3-30B, f85e2a3fc16e5d3242 pour le profil apparié de gpt-oss-120b). Chaque ligne porte la commande exacte, le noyau, les révisions Hugging Face et le RSS mesuré : vous pouvez rejouer, contredire, affiner.
- Données complètes : benchmarks.csv
- Essais de concurrence : concurrency.csv
- Dictionnaire des colonnes : README
- Données des graphiques : chart-data.json
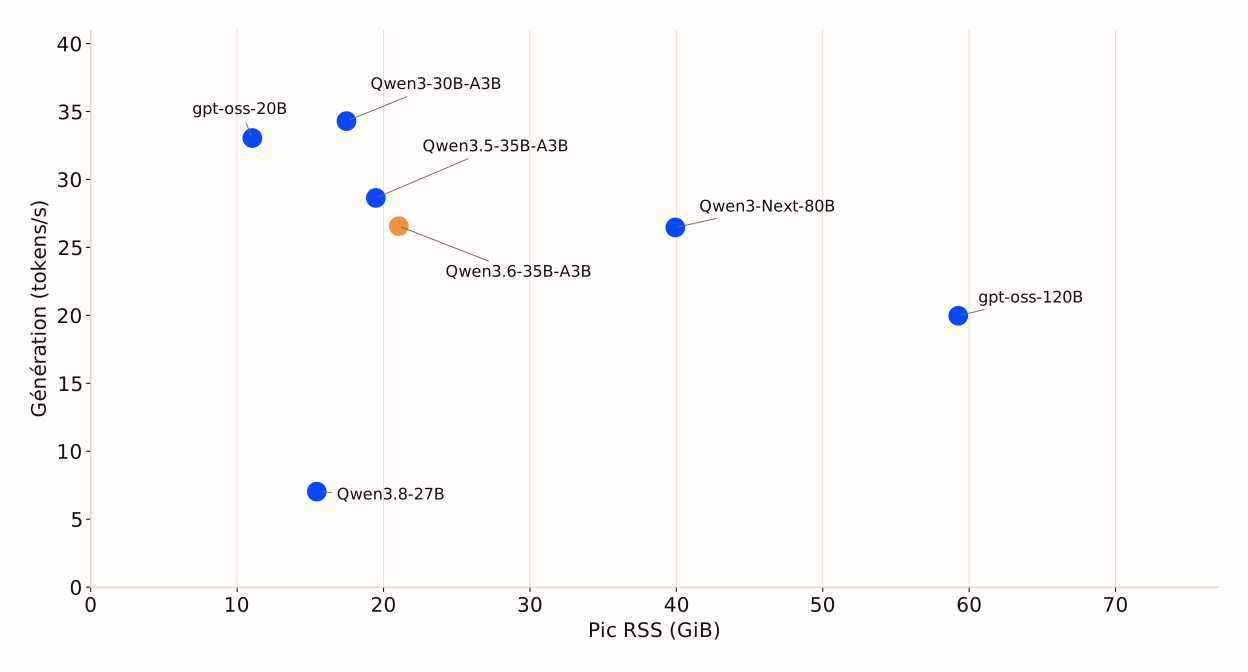
Le Qwen3.6 retenu approche le débit du 80B avec un pic RSS de benchmark nettement inférieur : 21 Gio contre environ 40 Gio. Cela simplifie le budget mémoire, sans démontrer une qualité égale. Nous ne reprenons pas le graphique Artificial Analysis du PDF : plusieurs pages sources décrivent des variantes avec raisonnement qui ne correspondent pas à nos profils de service. Les performances locales et les évaluations de qualité externes restent deux sources distinctes. Avant un déploiement, il faut ajouter le cache KV, le cache de prompt et les requêtes simultanées au budget mesuré, puis vérifier les réponses sur les tâches réelles.